

Le coût d’une réponse d’intelligence artificielle peut baisser alors que la facture de son utilisateur augmente. Entre l’abonnement, les volumes de texte traités, les recherches et les reprises, le prix affiché ne suffit pas à mesurer le budget. Les tarifs officiels consultés le 10 novembre 2026 permettent de décomposer cette dépense, sans confondre une réponse bon marché avec un travail correctement terminé.
Après la mémoire vive, les processeurs et la facture électrique, la série sur les prix aborde une dépense moins visible : celle d’un logiciel qui consomme du calcul à chaque utilisation. Pour un indépendant, une petite entreprise ou une association, la question pratique est de savoir ce qui reste compris dans le forfait et ce qui varie avec l’activité.
De 2022 à 2024, une baisse à performance définie
L’AI Index 2025 de Stanford, publié le 7 avril 2025, fournit un repère historique : le coût d’interrogation d’un modèle atteignant le score de GPT-3.5 sur le test MMLU passe de 20 dollars par million de jetons en novembre 2022 à 0,07 dollar en octobre 2024. Le seuil retenu est de 64,8 % de réponses correctes. Le point final correspond à Gemini-1.5-Flash-8B.
| Période | Dollars par million de jetons |
|---|---|
| Novembre 2022 | 20,00 |
| Octobre 2024 | 0,07 |
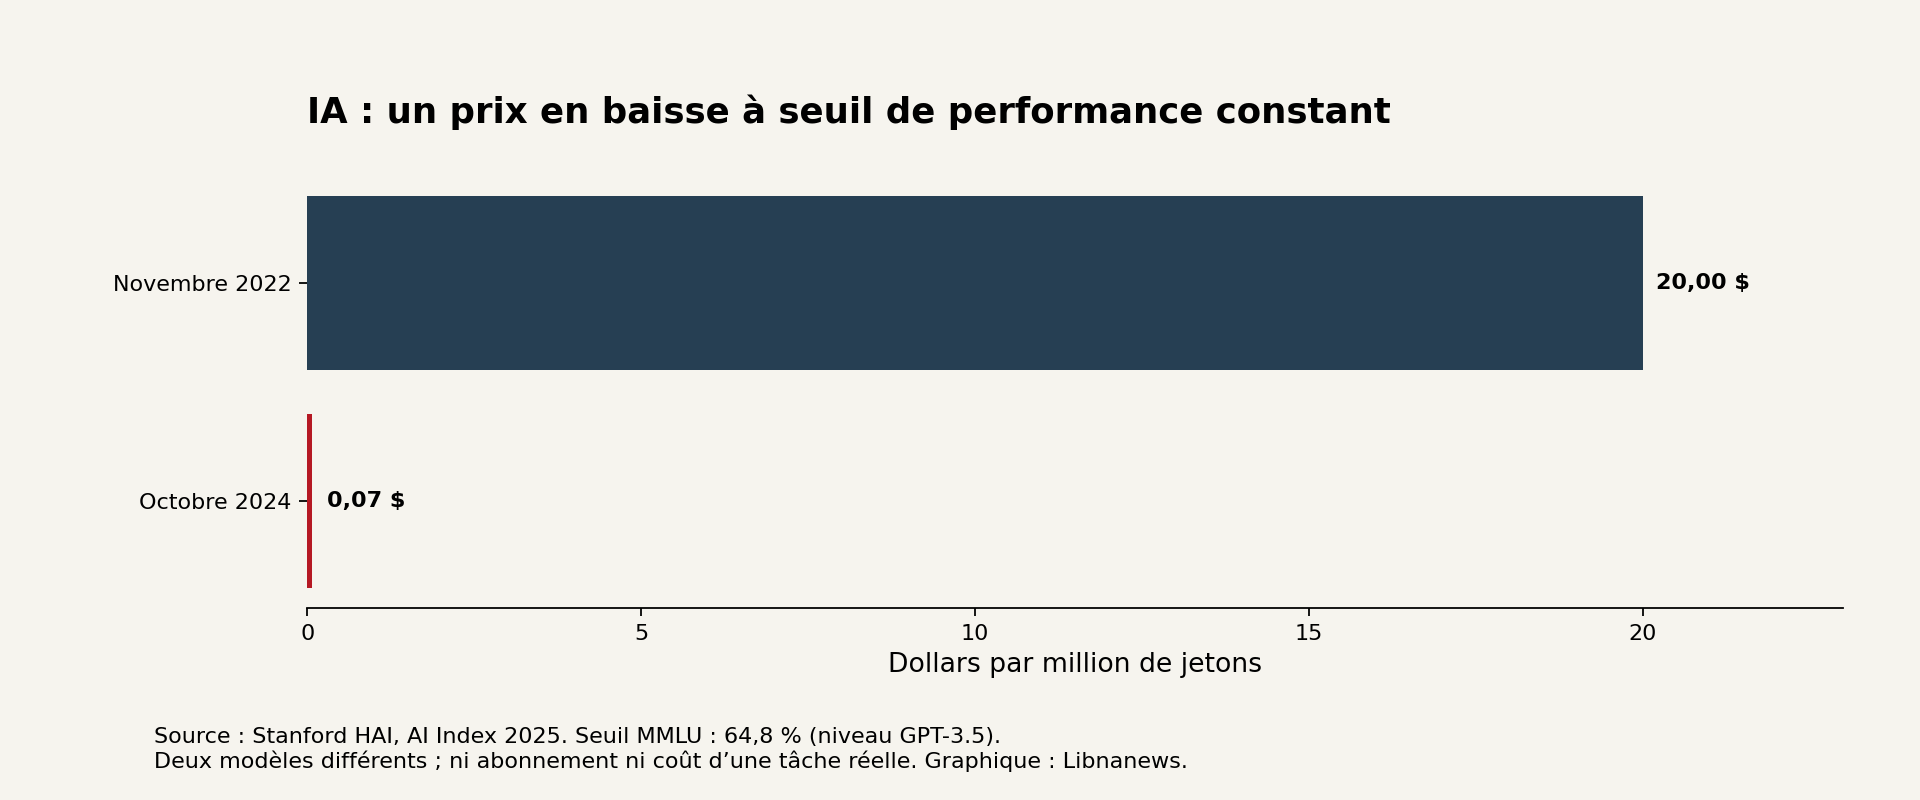
Ce sont deux observations à un seuil de performance déterminé, pas le tarif du même produit conservé deux ans. Elles ne mesurent ni le prix d’un abonnement ni la réussite d’un agent dans une entreprise. Le ratio dépasse 280, mais on ne peut pas le prolonger jusqu’en 2026 sans conserver la même méthode. Les tarifs actuels ci-dessous constituent donc un second tableau, distinct de cette série historique.
Abonnement et consommation ne paient pas la même chose
Dans une application, un abonnement donne accès à des fonctions et à une capacité d’utilisation. Une API est une interface qui permet à un autre logiciel d’interroger le modèle ; sa consommation est généralement comptée. Une entreprise qui automatise le traitement de documents doit donc lire les conditions de l’API, même si ses salariés disposent déjà d’un abonnement.
La grille Claude illustre cette distinction : Pro est affiché à 20 dollars par mois en paiement mensuel, ou 200 dollars payés d’avance pour l’année. Max coûte 100 dollars par mois et Ultra 200 dollars, hors taxes applicables. Des limites d’utilisation subsistent ; la quantité consommée dépend notamment du modèle, de la longueur des conversations et des fichiers.
Il serait toutefois inexact d’affirmer que les deux factures sont toujours totalement séparées. Anthropic prévoit désormais des crédits API pour certains abonnés : 100 dollars mensuels pour Max et 200 pour Ultra, sous conditions d’activation. Ils expirent à la fin du cycle et ne se reportent pas. Ils ne couvrent ni Claude Code, ni les dépassements dans les applications Claude, ni les plateformes partenaires. Leur montant ne constitue donc pas une remise universelle sur toutes les utilisations de la marque.
Un panier identique de jetons, pas une promesse de résultat identique
Un jeton est une unité de texte traitée par le modèle, pas nécessairement un mot. L’entrée comprend ce qu’on lui transmet ; la sortie correspond à sa production facturée. Pour rendre les tarifs lisibles, le tableau suivant applique les prix de base à un panier purement illustratif : un million de jetons d’entrée non mis en cache et 200 000 jetons de sortie facturables, cumulés sur plusieurs requêtes courtes. Il exclut outils, taxes, crédits promotionnels, modes accélérés et traitements longs majorés.
| Modèle | Entrée par million | Sortie par million | Coût du panier |
|---|---|---|---|
| GPT-6 Luna | 0,10 | 0,50 | 0,20 |
| GPT-6.1 Sol | 2,00 | 10,00 | 4,00 |
| Claude Sonnet 5.5 | 2,00 | 10,00 | 4,00 |
| Claude Opus 5.5 | 4,00 | 20,00 | 8,00 |
| Claude Fable 5.2 | 8,00 | 40,00 | 16,00 |
Les montants proviennent des grilles OpenAI, mode standard et contexte court, et Anthropic, tarifs de base. Le calcul est entrée + 0,2 × sortie. Deux prix identiques ne signifient pas deux modèles interchangeables. Un même document peut aussi produire un nombre différent de jetons selon le modèle. Cette simulation compare des unités facturées ; elle ne classe ni l’exactitude, ni la rapidité, ni le coût d’un dossier réellement achevé.
Pourquoi les longues réponses pèsent davantage
Dans le panier à 4 dollars, les entrées coûtent 2 dollars et les sorties 2 dollars. Pourtant, il y a cinq fois moins de jetons en sortie. À ces tarifs, demander une production plus longue change donc rapidement la dépense. Si la sortie passe de 200 000 à 400 000 jetons, avec la même entrée, le total atteint 6 dollars : une hausse de 50 %. Il s’agit d’un calcul de scénario, pas d’une facture observée.
Les recherches peuvent s’y ajouter. La grille OpenAI affiche notamment 10 dollars pour 1 000 appels de recherche web standard, auxquels s’ajoute la facturation des contenus de recherche transmis au modèle. Mille recherches ne se confondent donc pas avec mille simples réponses textuelles. Un outil qui vérifie plusieurs pages, reformule et recommence peut multiplier les postes de consommation avant de livrer quelques paragraphes.
Réutiliser un document peut réduire sa refacturation
La mise en cache des instructions et documents évite de recalculer certains éléments déjà traités. Elle porte sur une partie commune située au début de la requête, qui doit rester identique. Maintenir une conversation ne garantit pas à lui seul que cette réduction s’applique.
Pour GPT-6.1 Sol, le tarif de lecture du cache est de 0,10 dollar par million de jetons, contre 2 dollars pour une entrée ordinaire. Mais l’écriture initiale dans le cache a également un prix : 2,50 dollars avec la durée de conservation standard de trente minutes. Comparer uniquement 0,10 à 2 dollars ferait disparaître cette première dépense.
Exemple simplifié : une même portion de 100 000 jetons, intégralement réutilisable, coûte 0,25 dollar à écrire puis 0,09 dollar pour neuf lectures. Le total est de 0,34 dollar, contre 2 dollars pour dix traitements ordinaires. Ce calcul exclut les sorties et les nouvelles informations ajoutées ; il suppose neuf réutilisations réussies avant expiration. Il ne décrit pas le prix d’une conversation entière.
Attendre peut coûter moins cher
La vitesse constitue un autre choix économique. L’API Batch d’OpenAI propose une réduction de 50 % par rapport aux appels synchrones, avec une fenêtre de traitement de vingt-quatre heures. Le fournisseur la destine notamment à la classification de grands ensembles et aux évaluations.
Pour une entreprise qui classe ses documents pendant la nuit, ce délai peut être acceptable. Pour un service répondant immédiatement à un client, il change le service rendu. Le montant inférieur rémunère donc une autre contrainte de livraison. Il ne faut pas additionner mécaniquement toutes les réductions annoncées sans vérifier que le modèle et le mode choisis les permettent.
Le bon dénominateur : la tâche correctement terminée
Dans son guide d’optimisation, Anthropic recommande de comparer le coût par tâche achevée plutôt que le seul prix du jeton. Un modèle plus cher à l’unité peut réduire les reprises ; inversement, employer le plus coûteux pour chaque classement élémentaire peut alourdir inutilement le budget. Les résultats présentés par le fabricant restent propres à ses essais et ne remplacent pas un test sur les documents du client.
La méthode concrète consiste à prendre un échantillon stable, à définir ce qu’est une réponse acceptable, puis à relever consommation, erreurs et corrections. Les dossiers difficiles doivent rester dans cet échantillon. Les retirer améliorerait artificiellement le coût moyen et masquerait précisément les cas qui demandent le plus de travail.
OpenAI identifie de son côté trois leviers dans son guide de réduction des coûts : limiter le nombre de requêtes, réduire les volumes de texte et choisir un modèle plus petit lorsque l’exactitude reste suffisante. Pour le lecteur, cela se traduit par des questions simples : faut-il renvoyer le dossier complet, obtenir dix pages au lieu d’une synthèse, ou relancer toute la tâche pour une seule correction ?
Le budget à suivre comporte ainsi plusieurs lignes : forfait éventuel, consommation nette après crédits réellement utilisables, outils, puis temps humain de vérification. Aucun barème public ne permet d’attribuer un prix universel à cette dernière ligne. C’est précisément pourquoi un prix au million de jetons, même très bas, ne permet pas à lui seul de promettre une économie sur le travail final.

Commentaires